故障排查
自动转录为什么不准,以及如何修正
排查语言选错、噪声、重叠说话、姓名和说话人错误,并在 Transcrever 中对照录音修正。
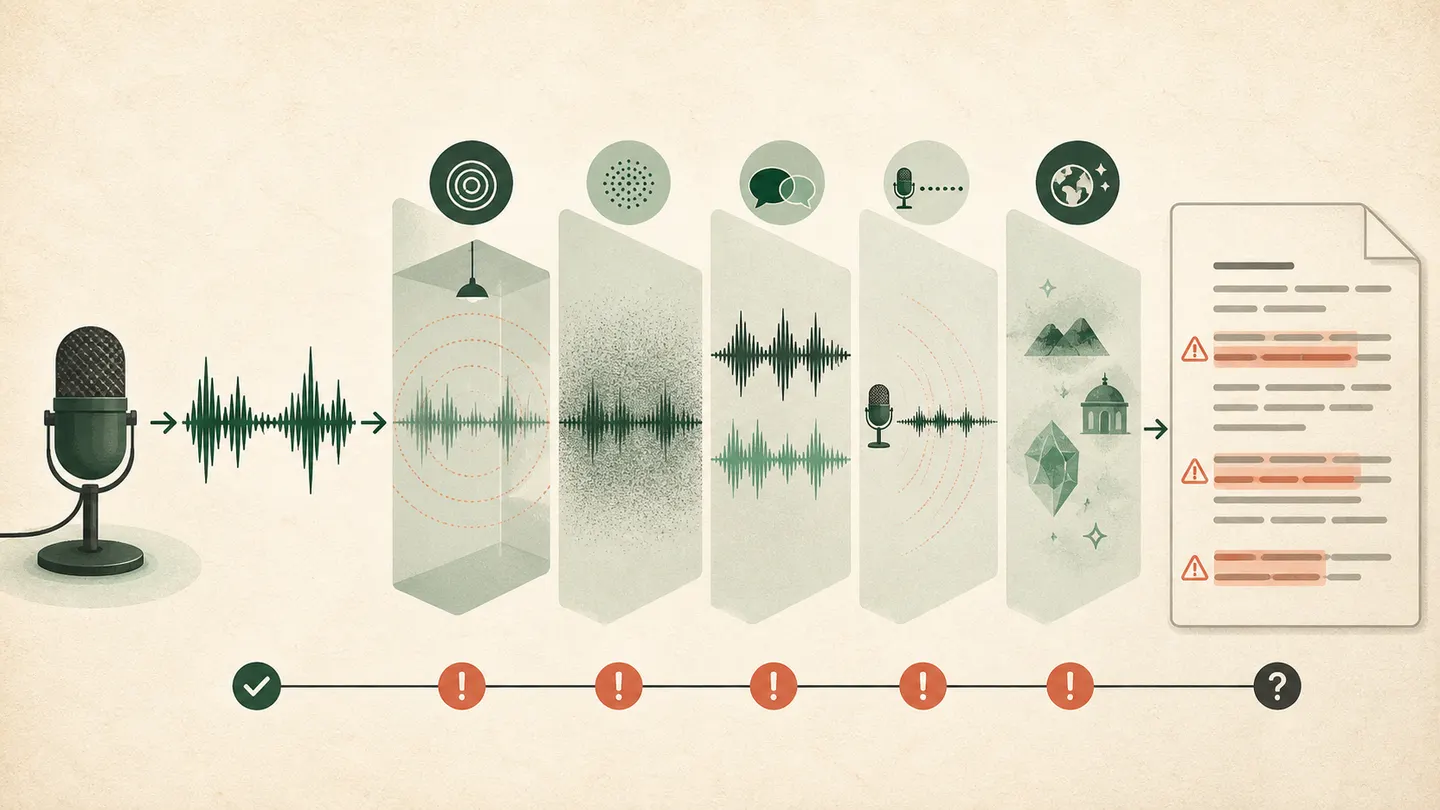
自动转录不准时,先检查出错片段,不要盲目重做整个文件。在 Transcrever 编辑器中搜索某个词,或打开出错时间,播放前后几秒并对照文字。错误类型会告诉你下一步应该修正姓名、确认说话人、更换语言,还是寻找更好的源文件。
快速诊断:出了什么问题?
| 文字症状 | 可能原因 | 首先要做的事 |
|---|---|---|
| 大量句子没有意义 | 选择的语言与录音不符 | 检查语言,必要时重新提交 |
| 某段内容消失 | 声音太小、截断、噪声或遮盖 | 听缺口前后的录音 |
| 姓名变成常见词 | 专有名词缺少上下文 | 查看议程或参与者名单 |
| 说话人分错 | 声音相似、音量不等或重叠 | 跨越切换点回听,并修改该片段的说话人 |
| 整体效果很差 | 音源距离远、失真或过度压缩 | 寻找更接近原始的文件 |
1. 逐句修改前先检查语言
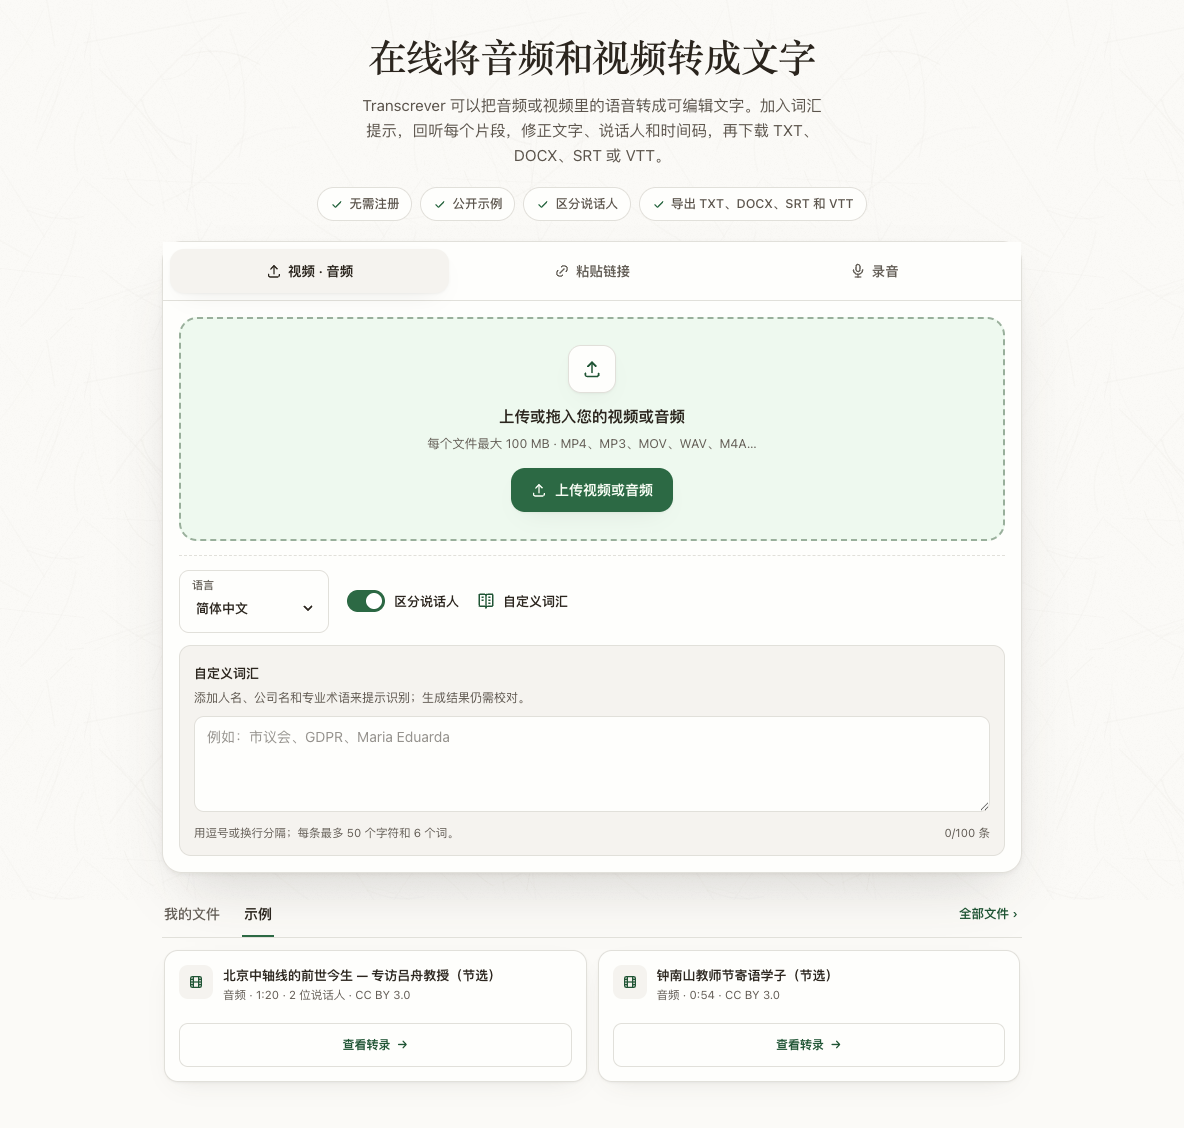
错误的语言会改变系统认为可能的词。结果看似是真实词语,句子却无法连接。返回上传页,确认录音的主要语言。
2. 听噪声、距离和回声是否遮盖人声
麦克风距离远时,它会收录更多环境声。交通、风扇、键盘和其他人的声音会与人声竞争,回声也会让辅音和词尾变得模糊。Google Cloud 的语音数据建议也建议缩短麦克风距离,避免截幅,并亲自听样本中的失真与噪声。
3. 把重叠说话当作必须回听的点
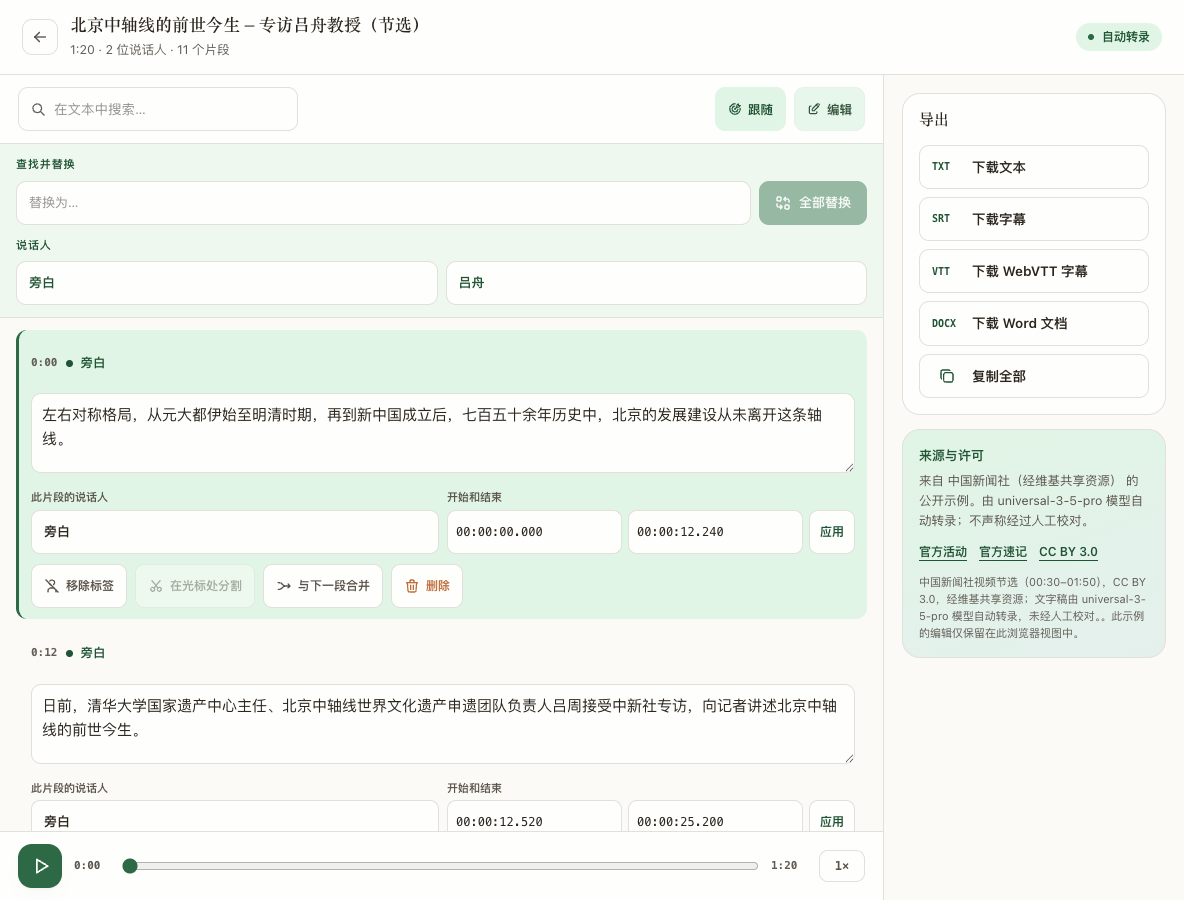
两人同时说话时,文字可能缺词、合并两句话,或标错说话人。说话人分离可以整理初稿,但不能保证每段归属。应从上一轮发言听到回答结束。如果只有一个片段归属错误,可以单独修改该片段的说话人;不需要显示姓名时,可以移除标签。只有同一个标签需要在全文统一更名时,才使用全局重命名。
如果一个片段同时包含上一位和下一位说话人的内容,可以把光标放在交界处拆分。两个连续碎片只有在说话人相同时才能合并。先用录音确认边界,不要只是为了让文字看起来整齐而改动结构。
4. 用其他资料核对姓名、缩写和数字
上传前准备一份简短参考表:参与者、机构、项目、日期和专业术语。在上传区打开“自定义词汇”,用逗号或换行分隔这些词。词汇表只用于提示识别,并不保证每个词都会正确出现,仍需对照录音和上下文校对。
结果生成后,在 Transcrever 中搜索这些词,回听完整片段后再修正拼写。如果同一个字面错误重复出现,可以使用“查找和替换”:它会在所有片段文字中进行不区分大小写的字面替换,并显示替换数量。它不会修改录音、说话人或时间码。应用到全文前,至少先核对一处;参考表用于确认拼写,不能用来补写听不清的内容。
5. 在 Transcrever 中按顺序修正
- 搜索姓名、数字、日期和否定词;
- 播放包含上下文的片段;
- 只修改能确认的文字,只有每个字面匹配都需要同样修正时才执行全部替换;
- 修改单个片段的说话人,移除不需要的标签,并在录音支持时拆分或合并片段;
- 确认某个片段不应保留后再删除;
- 只有播放证明同步有误时才修改开始和结束时间,编辑器会拒绝无效或重叠范围;
- 再读一遍片段,并为下一步选择文件。
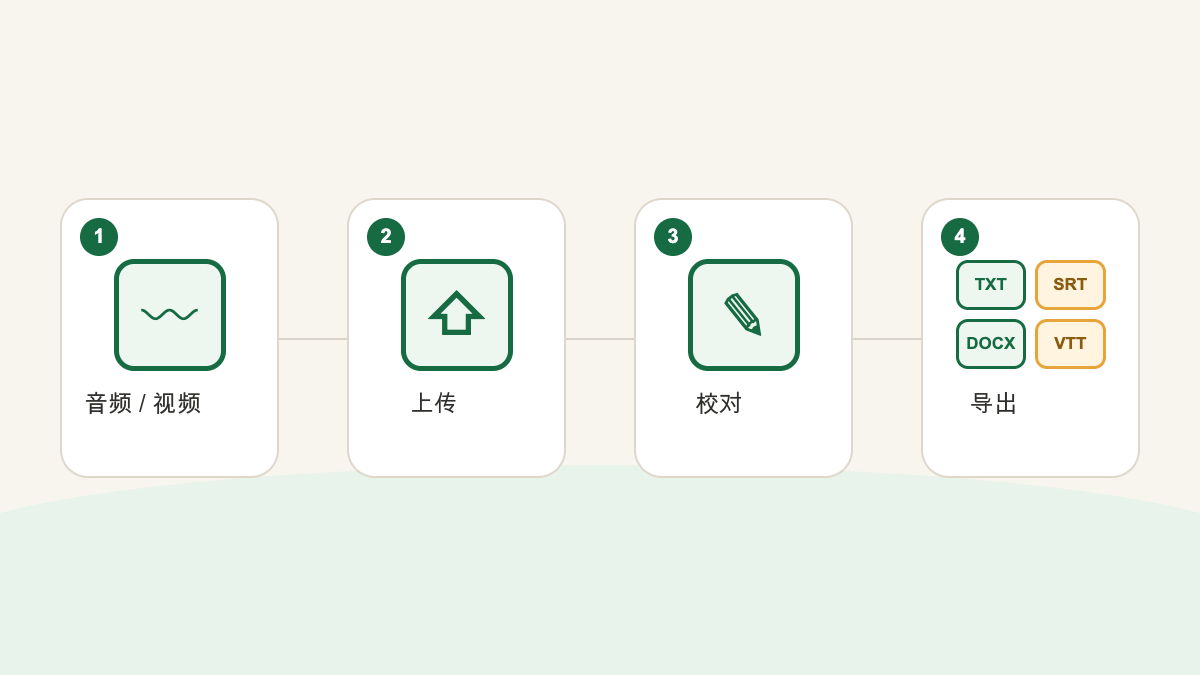
需要纯文本时下载 TXT,需要在文档软件中继续编辑时下载 DOCX,需要 SubRip 字幕时下载 SRT,平台使用 WebVTT 时下载 VTT。SRT 和 VTT 会保留校对后的时间范围,但不会设置字幕样式、位置,也不会把字幕烧录进视频。发布前仍要把字幕文件和最终视频一起播放检查。
尚未生成文字时,从音频转文字开始;多人录音则参考会议转录流程。
6. 决定是修改、重新提交还是更换录音
错误集中在姓名、标点、某个说话人或少数可听清片段时,直接在编辑器修改。语言选错或找到更好的源文件时,重新提交。人声长时间听不清、失真或被遮盖时,需要寻找其他录音。
常见问题
调大音量能改善转录吗?
可能更容易听,但也会放大噪声,无法恢复已丢失的频率或失真。
降噪一定有用吗?
不一定。过强的滤波会把人声一起删掉。应对副本进行测试并与原件比较。
音频清晰时姓名为什么还会错?
姓名比常见词缺少可预测的上下文。上传前可以把预计出现的姓名加入自定义词汇来提示识别,结果生成后仍要查证拼写并回听完整片段。词汇表不能代替校对。
自定义词汇和全部替换有什么区别?
自定义词汇随录音一起提交,用来提示可能出现的姓名和术语,但不保证识别结果。全部替换在转录完成后运行,只改变已生成文字中的字面匹配。前者提供识别上下文,后者应在确认所有匹配都需要同样修正后使用。
如何更快校对长录音?
先处理会被使用的姓名、数字、日期、引用和说话人切换,再导出已修正结果。